Erfahrungsbericht zu unserem R&D-Projekt: Entwicklung einer KI für die automatische Validierung von Dokumenten und Nachweisen
Stellen Sie sich folgende Situation vor: Ihre Kunden müssen Nachweise einreichen, um eine Zusatzleistung in Anspruch zu nehmen. Rechnungen, Bescheinigungen, Zertifikate, diese Dokumente treffen in allen erdenklichen Formaten ein: gescannte PDFs, Handyfotos, Screenshots. Sie enthalten entscheidende Informationen, die geprüft werden müssen: Name des Antragstellers, Datum, Unternehmen, Stempel, Unterschrift, Produktcodes. Die Herausforderung? Diese Validierung, die Ihre Teams bisher viel Zeit kostete, zu automatisieren, und dabei ein absolut zuverlässiges Ergebnis zu gewährleisten. Das Problem? Unser erster Versuch einer KI-gestützten Automatisierung lieferte nicht die erwarteten Ergebnisse. Statt aufzugeben, starteten wir ein methodisches R&D-Projekt, um zu verstehen, warum, und wie wir unsere Vorgehensweise verbessern können.
Bevor wir die Leistung unserer KI messen konnten, mussten wir definieren, was eine „richtige Antwort“ ist. Das ist das Prinzip der _Ground Truth_, wörtlich „die Wahrheit aus der Praxis“. Konkret: Ein menschlicher Experte hat manuell etwa dreißig repräsentative Dokumente analysiert und für jedes akribisch dokumentiert: ✅ Name des Antragstellers vorhanden? Fehlt? ✅ Datum des Dokuments lesbar? Unleserlich? ✅ Unternehmen angegeben? Fehlt? ✅ Offizieller Stempel vorhanden? Fehlt? ✅ Unterschrift erkennbar? Nicht erkannt? ✅ Produktcode korrekt? Falsch? Dieser Schritt mag mühsam erscheinen, ist aber absolut entscheidend. Ohne diese zuverlässige Referenz lässt sich nicht feststellen, ob unsere KI Fortschritte macht oder Rückschritte erleidet!
Statt auf eine einzige Lösung zu setzen, haben wir zwei separate Analyse-Pipelines entwickelt, die jeweils mehrere spezialisierte KI-Modelle kombinieren können. Jede Pipeline wurde manuell mit unseren Referenzdokumenten getestet, wobei verschiedene Parameter und Modellkombinationen ausprobiert wurden, um die vielversprechendsten Konfigurationen zu identifizieren.
Sobald unsere Pipelines konfiguriert waren, haben wir sie auf alle 30 Referenzdokumente angewendet. Alle Ergebnisse wurden automatisch in einer Datenbank gespeichert, um sie später vergleichen zu können.
Nun kommt der entscheidende Moment: Die Vorhersagen unserer KI werden mit der von einem menschlichen Experten erstellten Ground Truth verglichen. Für jedes Dokument und jede gesuchte Information wissen wir jetzt, ob unser System richtig lag oder sich geirrt hat.
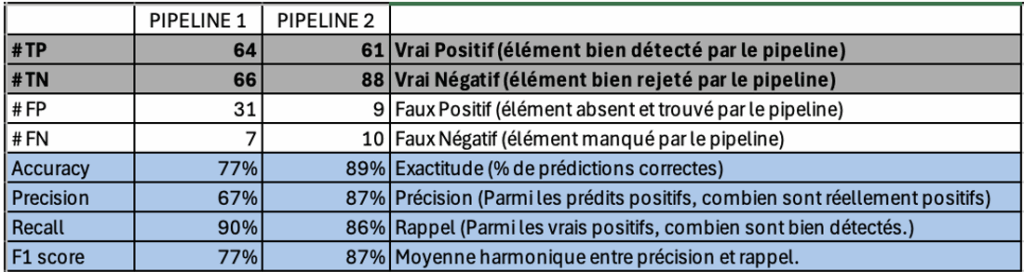
Um unsere Ergebnisse objektiv zu bewerten, nutzen wir vier klassische Kennzahlen aus dem Bereich der künstlichen Intelligenz. Hier ihre konkrete Bedeutung:
„Wie viele von 100 Prüfungen sind korrekt?“ Wenn unsere KI 100 Elemente prüft und davon 85 richtig identifiziert, liegt die Accuracy bei 85 %. Das ist der intuitivste Indikator, aber nicht immer der aussagekräftigste.
„Wenn die KI ‚vorhanden‘ sagt, wie oft hat sie recht?“ Erkennt die KI 20 Stempel und sind davon 18 tatsächlich vorhanden, liegt die Präzision bei 90 %. Dieser Indikator misst die Zuverlässigkeit positiver Erkennungen.
„Wie viele der tatsächlich vorhandenen Elemente hat die KI erkannt?“ Wenn 25 Dokumente tatsächlich einen Stempel enthalten und die KI 20 davon erkennt, liegt der Recall bei 80 %. Dieser Indikator misst die Fähigkeit, nichts Wichtiges zu übersehen.
„Wie gut ist das Gesamtgleichgewicht zwischen Präzision und Recall?“ Der F1-Score kombiniert Präzision und Recall zu einer einzigen Metrik. Je näher er an 100 % liegt, desto besser. Er ist oft der Referenzindikator, um verschiedene Ansätze zu vergleichen.
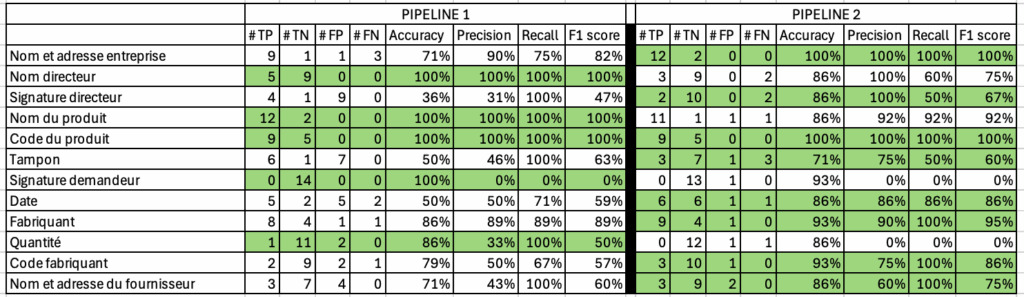
Wir haben diese Kennzahlen aus zwei Perspektiven berechnet:
Welche Pipeline liefert die besten Gesamtleistungen? Pipeline A oder Pipeline B?
Für jedes gesuchte Element (Name, Datum, Stempel usw.): welche Pipeline ist am zuverlässigsten? Wo liegen unsere Schwachstellen, die wir im Auge behalten müssen? Diese doppelte Analyse ermöglichte es uns, die beste Konfiguration auszuwählen und die Bereiche zu identifizieren, die im Produktivbetrieb besondere Aufmerksamkeit erfordern.
Dank dieses methodischen Vorgehens ist es uns gelungen, eine Pipeline zu entwickeln und zu validieren, die leistungsfähig genug für den Produktivbetrieb ist. Unser System automatisiert nun den ersten Schritt der Nachweisprüfung mit einem Konformitätsniveau, das es uns ermöglicht, die meisten Fälle eigenständig zu bearbeiten. Dennoch behalten wir ein wachsames Auge auf ein oder zwei spezifische Aspekte, die wir in unserer Analyse identifiziert haben, und garantieren so eine optimale Servicequalität. Der Gewinn? Schnellere Bearbeitung für Ihre Kunden, weniger repetitive Aufgaben für Ihre Teams und eine wissenschaftlich gemessene Zuverlässigkeit.
Dieser methodische Ansatz, von der Problemanalyse bis zur Validierung im Produktivbetrieb, zeigt, wie wir bei fAibrik künstliche Intelligenz im Dienste Ihrer Kundenbeziehung gestalten. Eine Idee? Ein Projekt? Melden Sie sich bei uns! Bei fAibrik verwandeln wir Ihre technischen Herausforderungen in konkrete Lösungen, mit der Sorgfalt eines wissenschaftlichen Vorgehens und der Einfachheit eines funktionierenden Services.